텍스트 청킹(chunking)은 RAG(Retrieval Augmented Generation) 파이프라인을 구축할 때 가장 중요한 단계 중 하나입니다. 문서를 어떻게 나누는지는 전체 시스템의 품질에 직접적인 영향을 미칩니다. 청킹 전략이 부실하면 관련 없는 컨텍스트가 프롬프트에 삽입되어 AI가 완전히 잘못된 답변을 내놓을 수 있습니다.
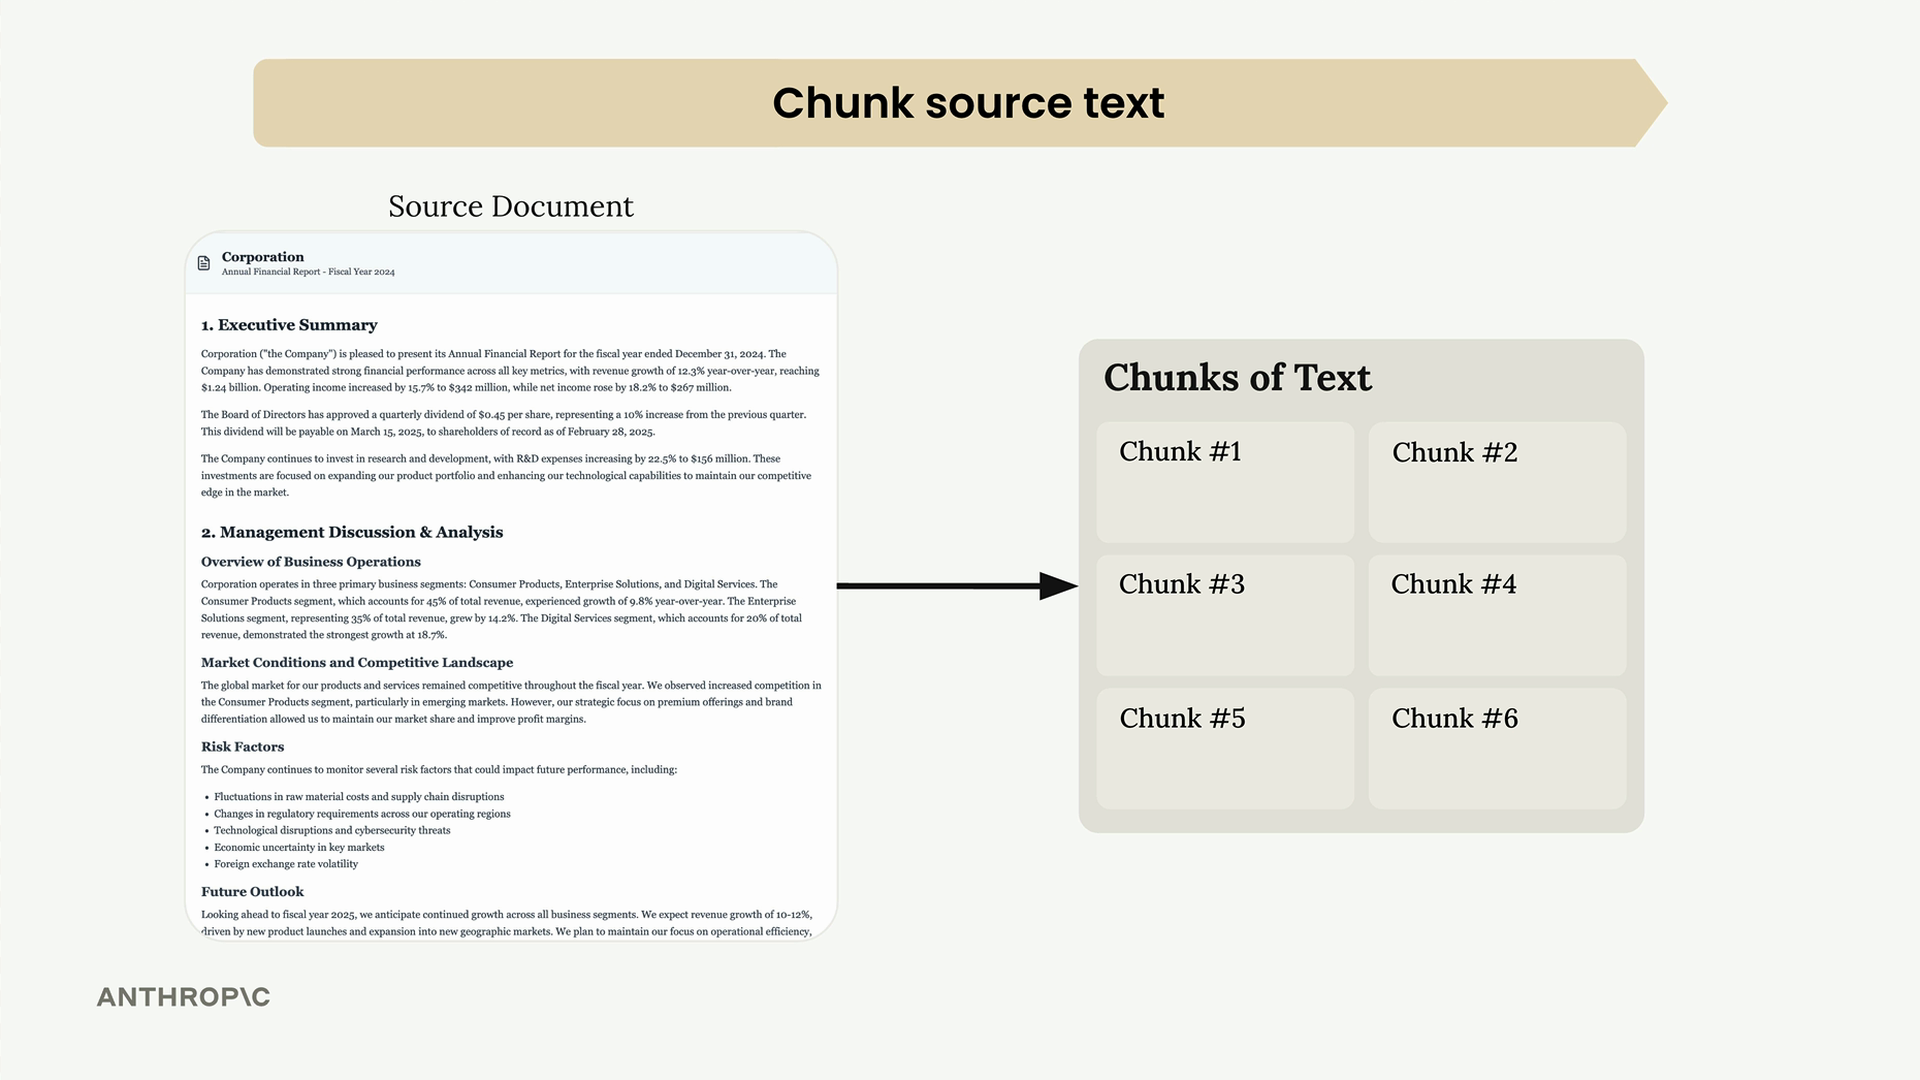
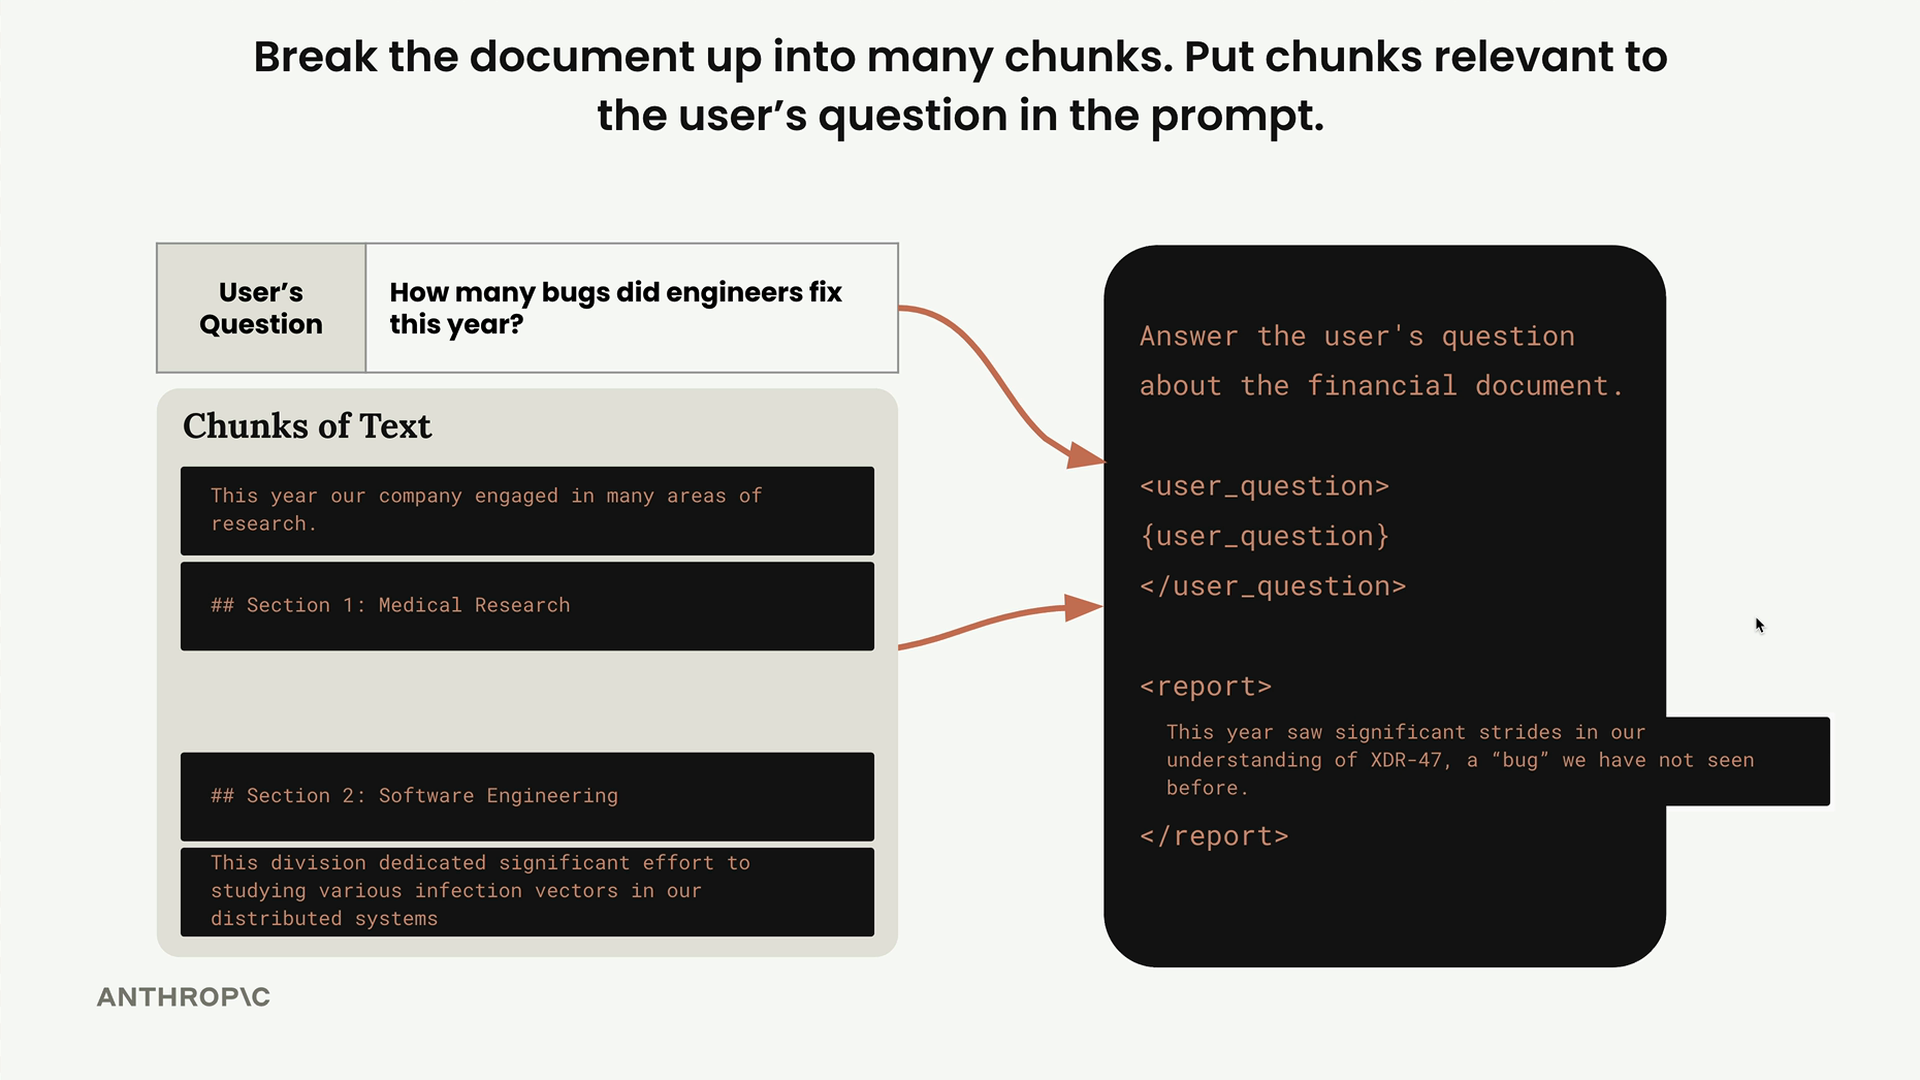
다음 예시를 생각해 보세요: 의료 연구와 소프트웨어 엔지니어링에 관한 섹션이 있는 문서가 있습니다. 청킹이 부실하면 "올해 엔지니어들이 몇 개의 버그를 수정했나요?"라고 묻는 사용자가 의료 연구에 관한 정보를 받을 수 있는데, 이는 단순히 의료 섹션에 다른 맥락에서 "버그"라는 단어가 포함되어 있었기 때문입니다.
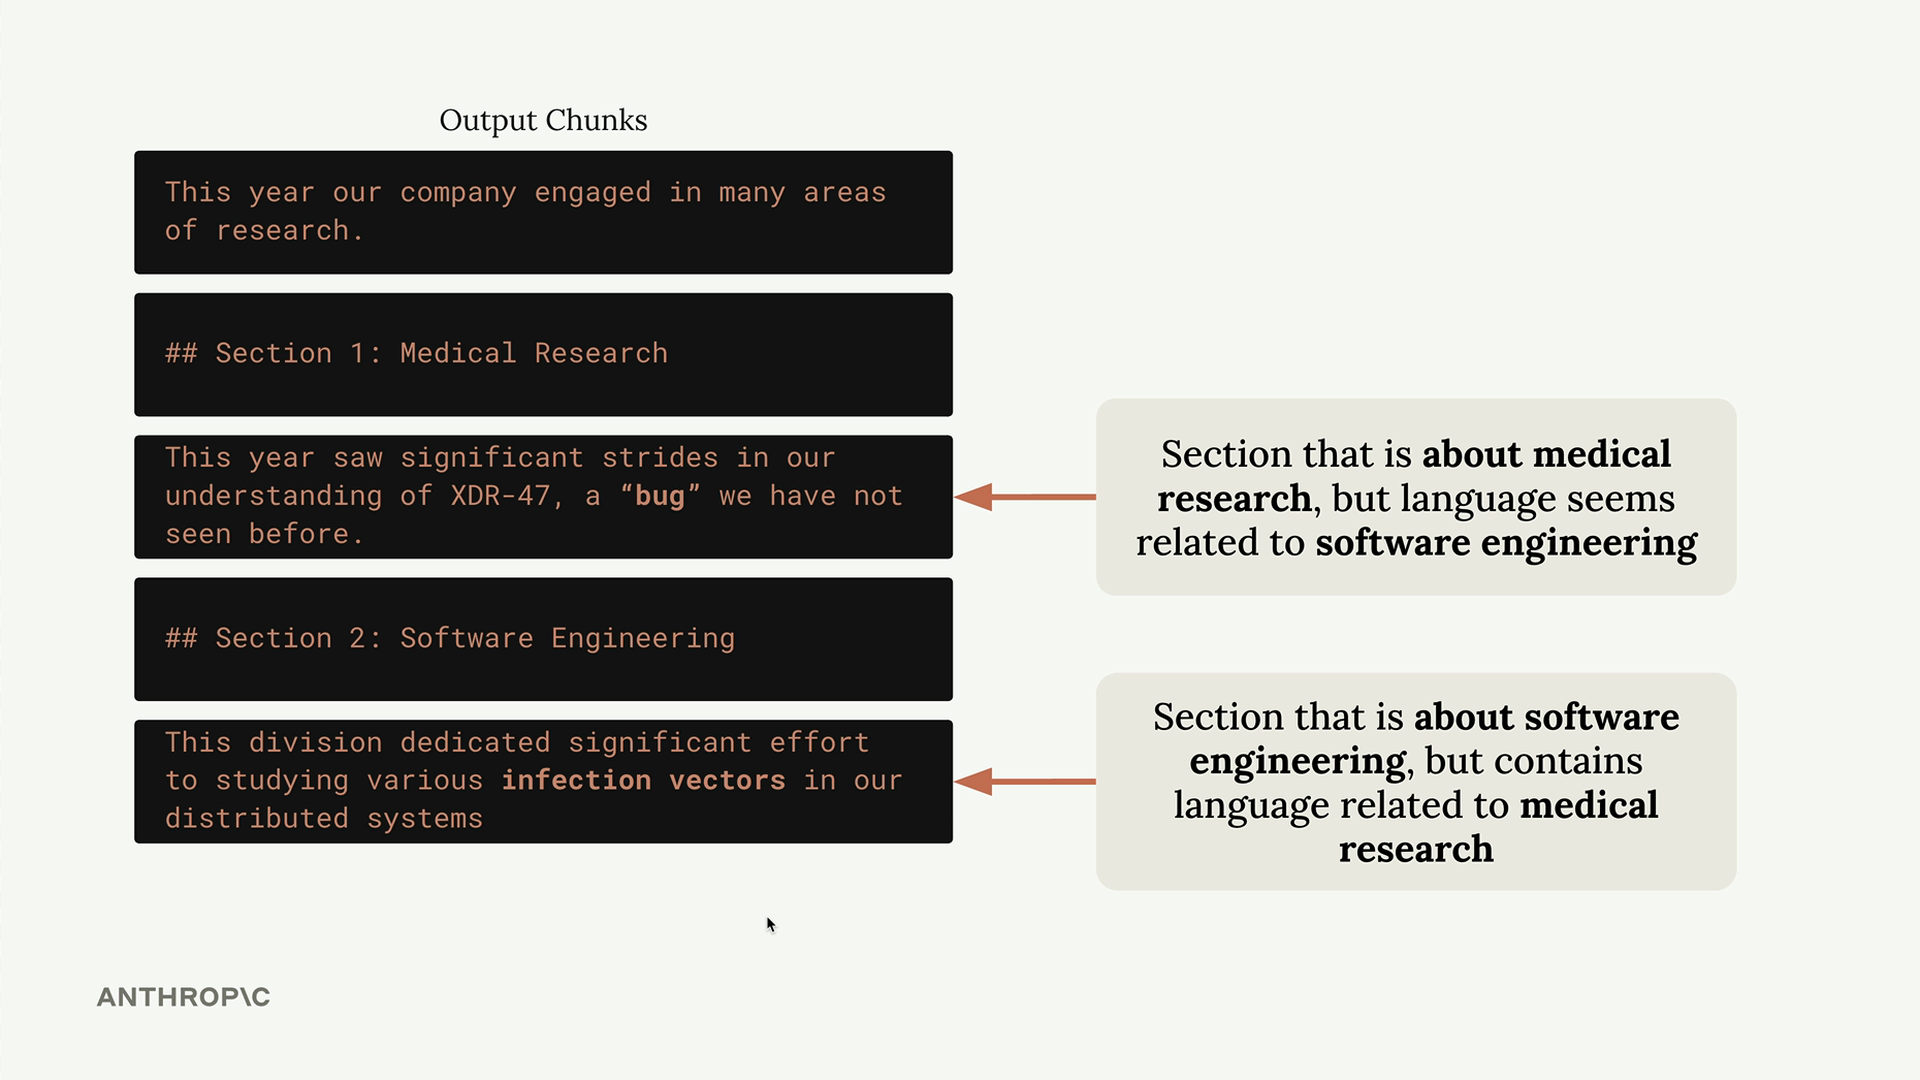
이는 청킹 전략이 왜 그렇게 중요한지를 보여줍니다. 목표는 의미적 일관성을 유지하고 검색되었을 때 유용한 컨텍스트를 제공하는 청크를 만드는 것입니다.
세 가지 주요 청킹 전략
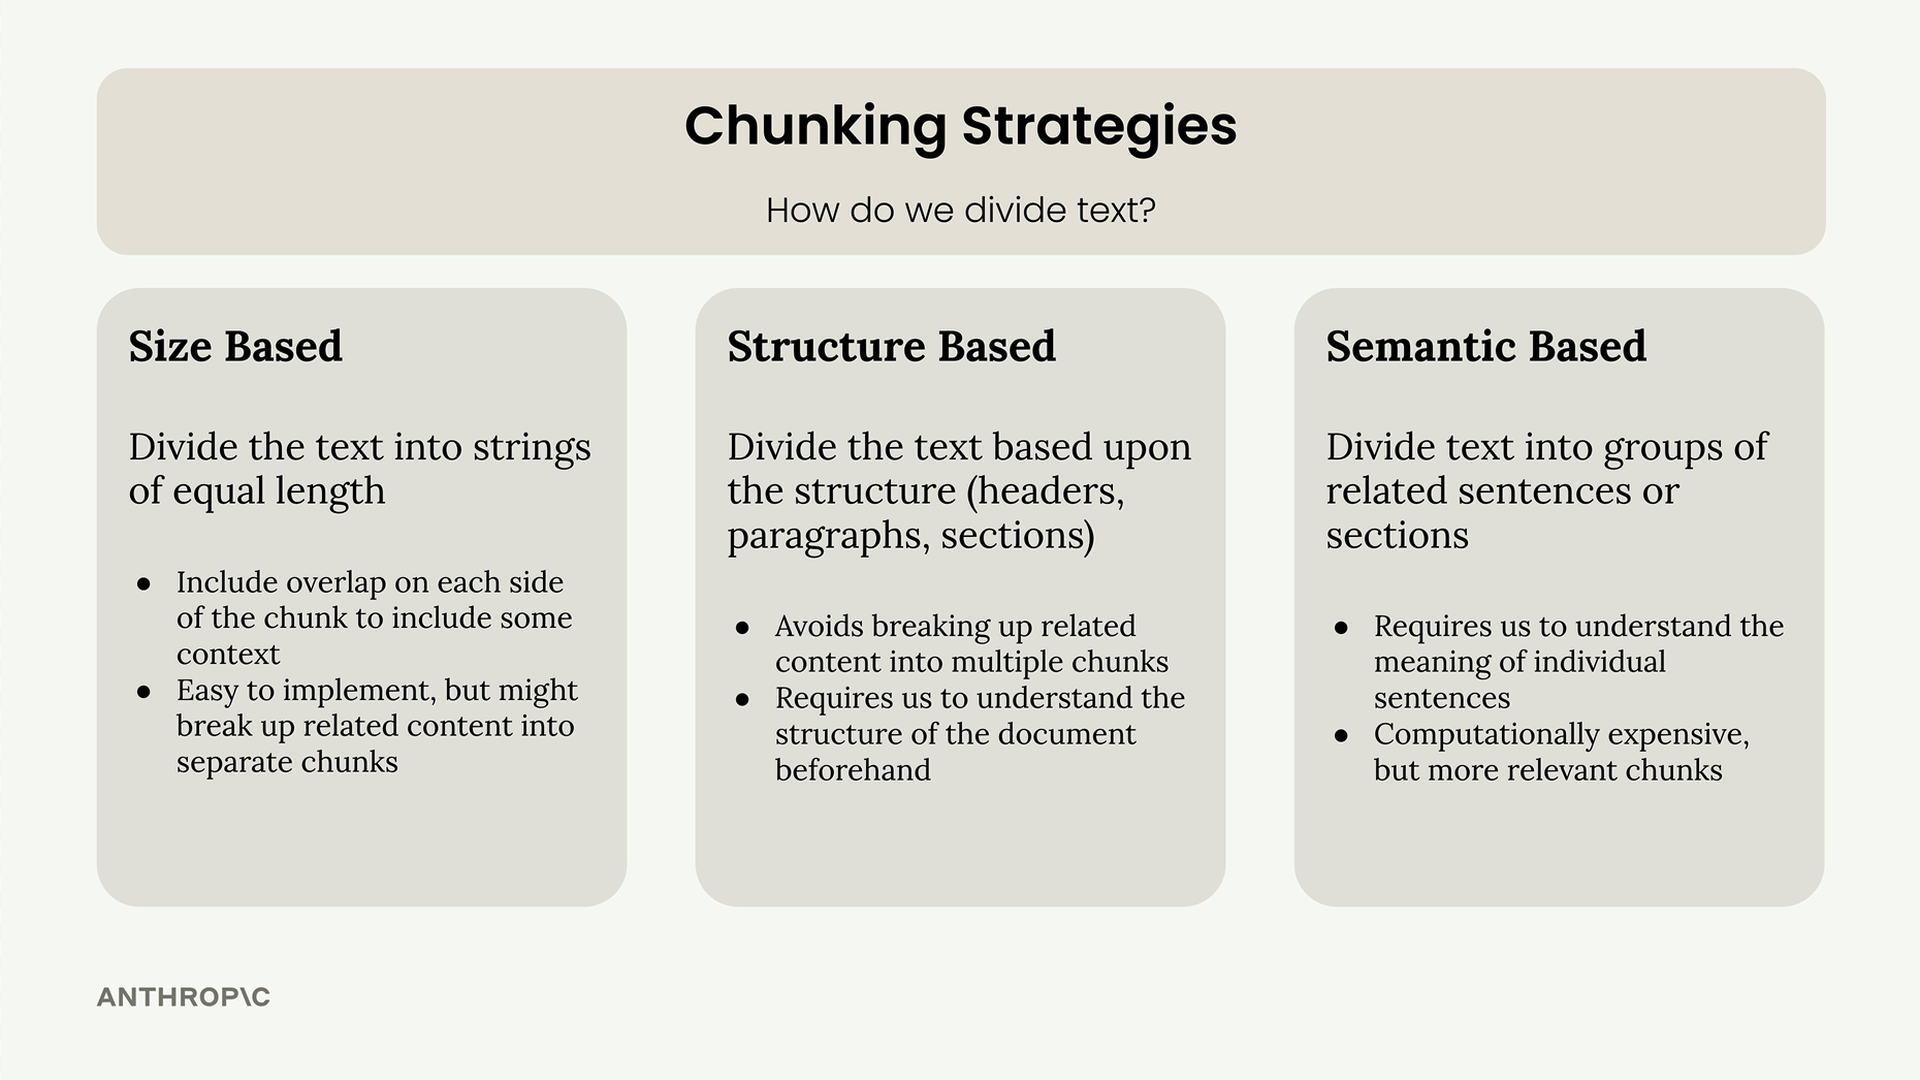
텍스트를 청크로 나누는 데는 세 가지 주요 접근 방식이 있습니다:
- 크기 기반(Size-based): 텍스트를 동일한 길이의 문자열로 나눕니다
- 구조 기반(Structure-based): 문서 구조(헤더, 단락, 섹션)를 기준으로 분할합니다
- 의미 기반(Semantic-based): NLP 기법을 사용하여 관련된 문장이나 섹션을 그룹화합니다
크기 기반 청킹
크기 기반 청킹은 가장 간단한 접근 방식입니다. 문서를 대략 동일한 문자 수 또는 단어 수의 청크로 나누기만 하면 됩니다. 구현이 쉽고 다양한 문서 유형에서 안정적으로 작동합니다.
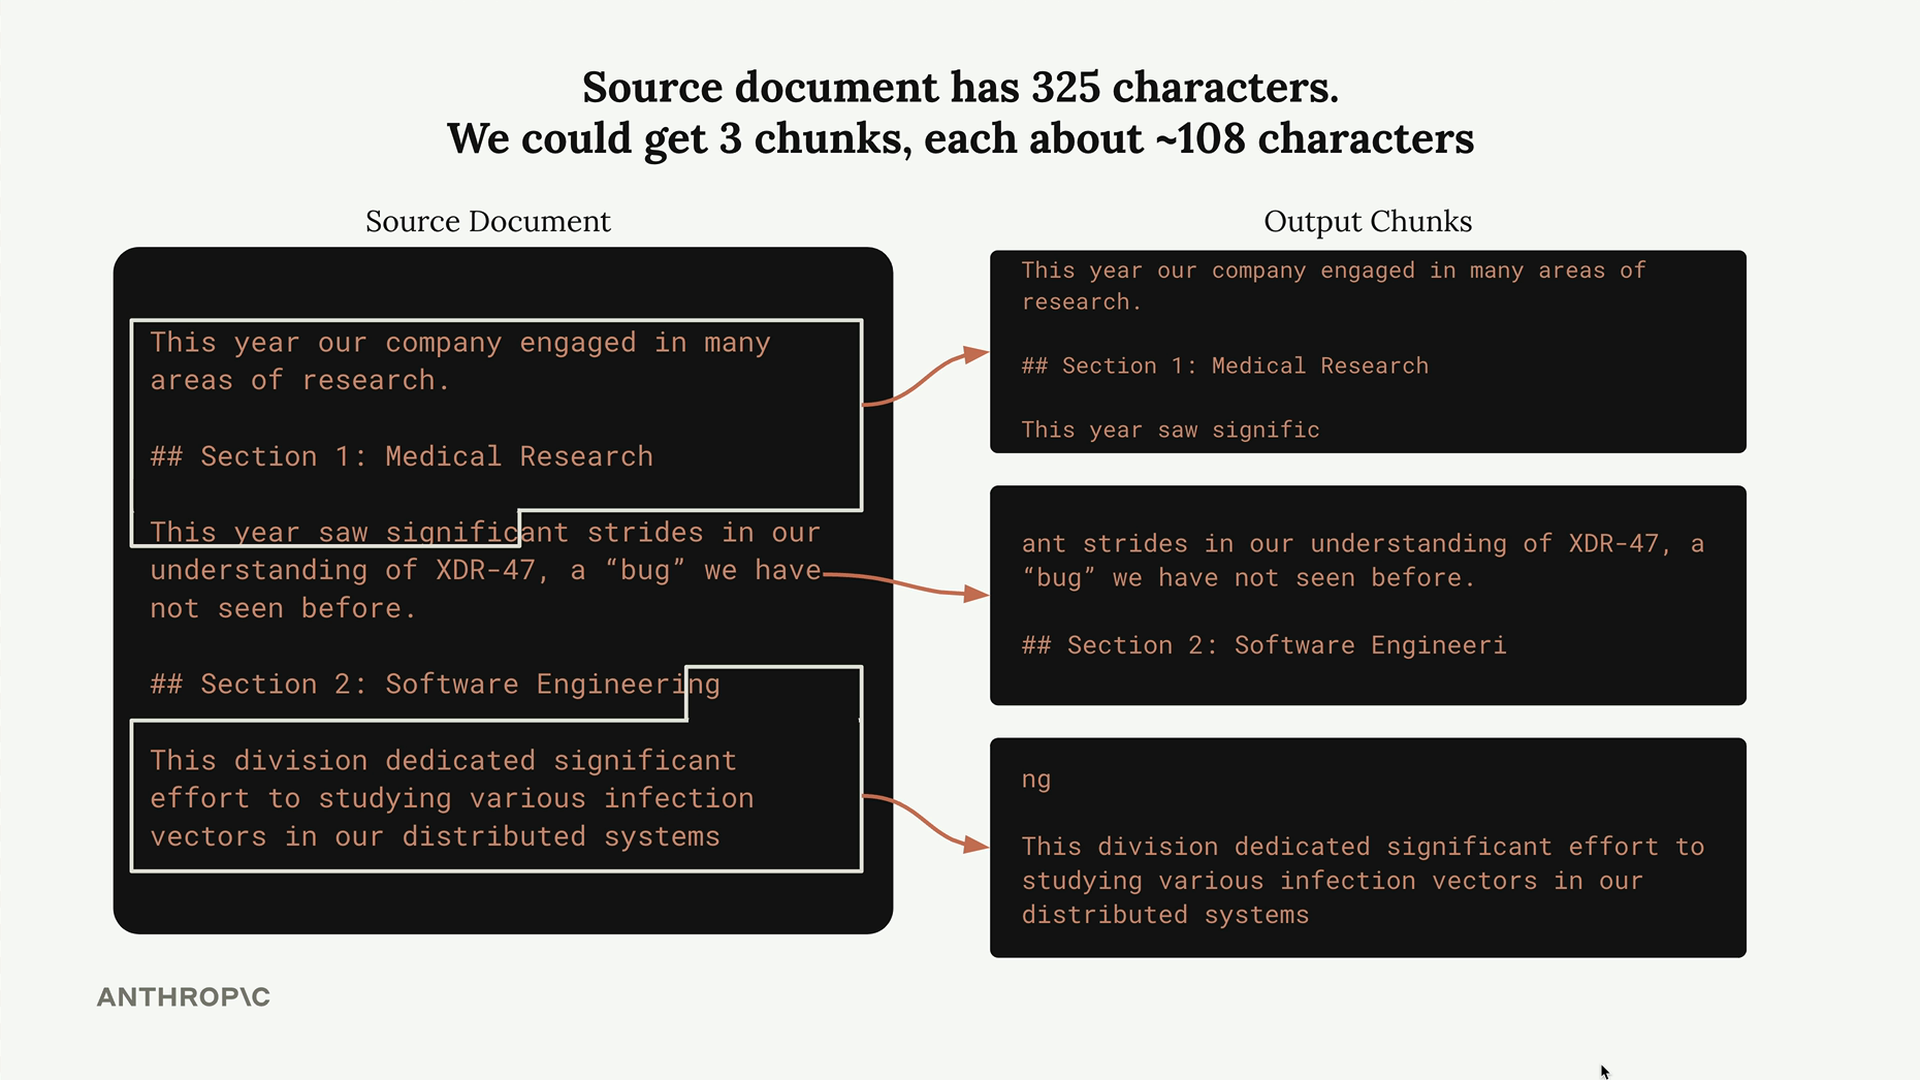
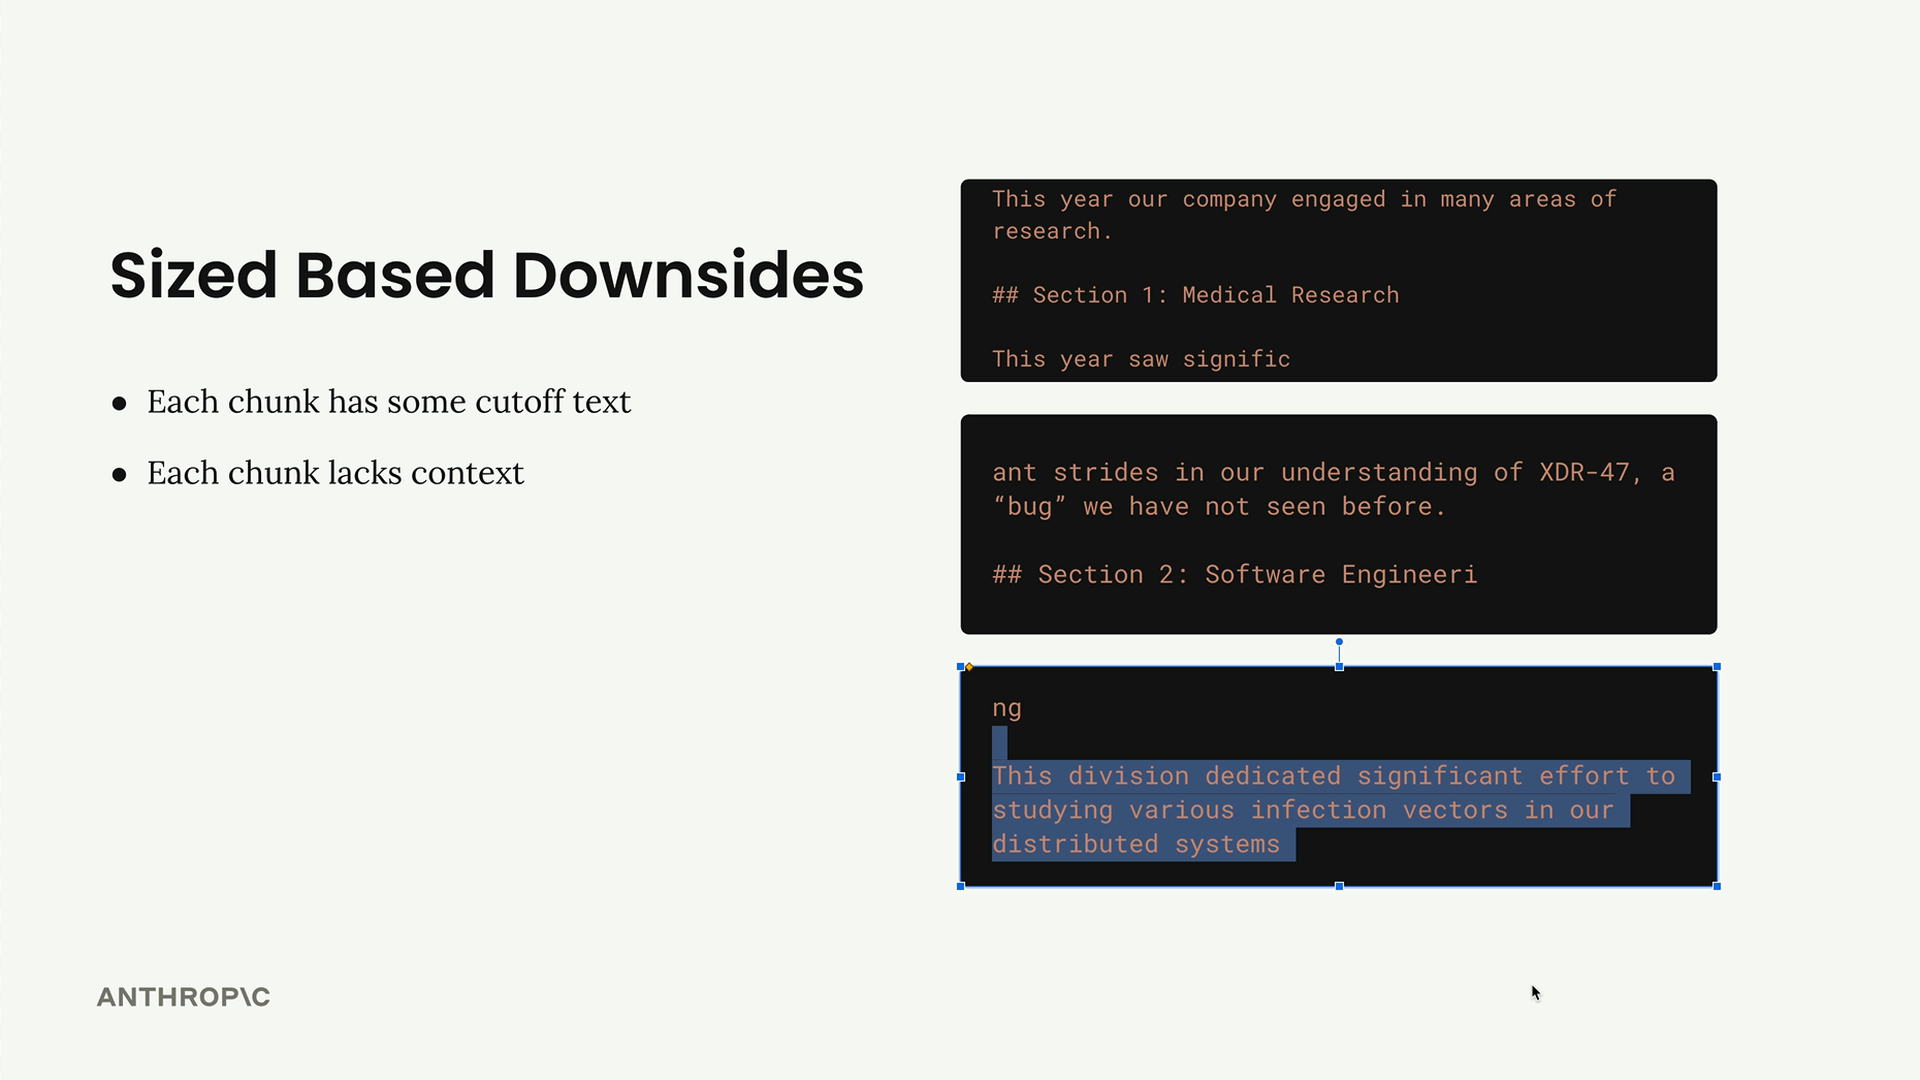
하지만 이 접근 방식에는 명확한 단점이 있습니다:
- 단어가 문장 중간에서 잘릴 수 있습니다
- 청크가 주변 텍스트에서 중요한 컨텍스트를 잃게 됩니다
- 관련된 내용이 여러 청크에 걸쳐 분할될 수 있습니다
오버랩 추가하기
컨텍스트 문제를 해결하기 위해 오버랩 전략을 구현할 수 있습니다. 각 청크는 인접한 청크의 일부 문자를 포함하여 추가적인 컨텍스트를 제공하고 청크 경계에서 중요한 정보가 손실되지 않도록 보장합니다.
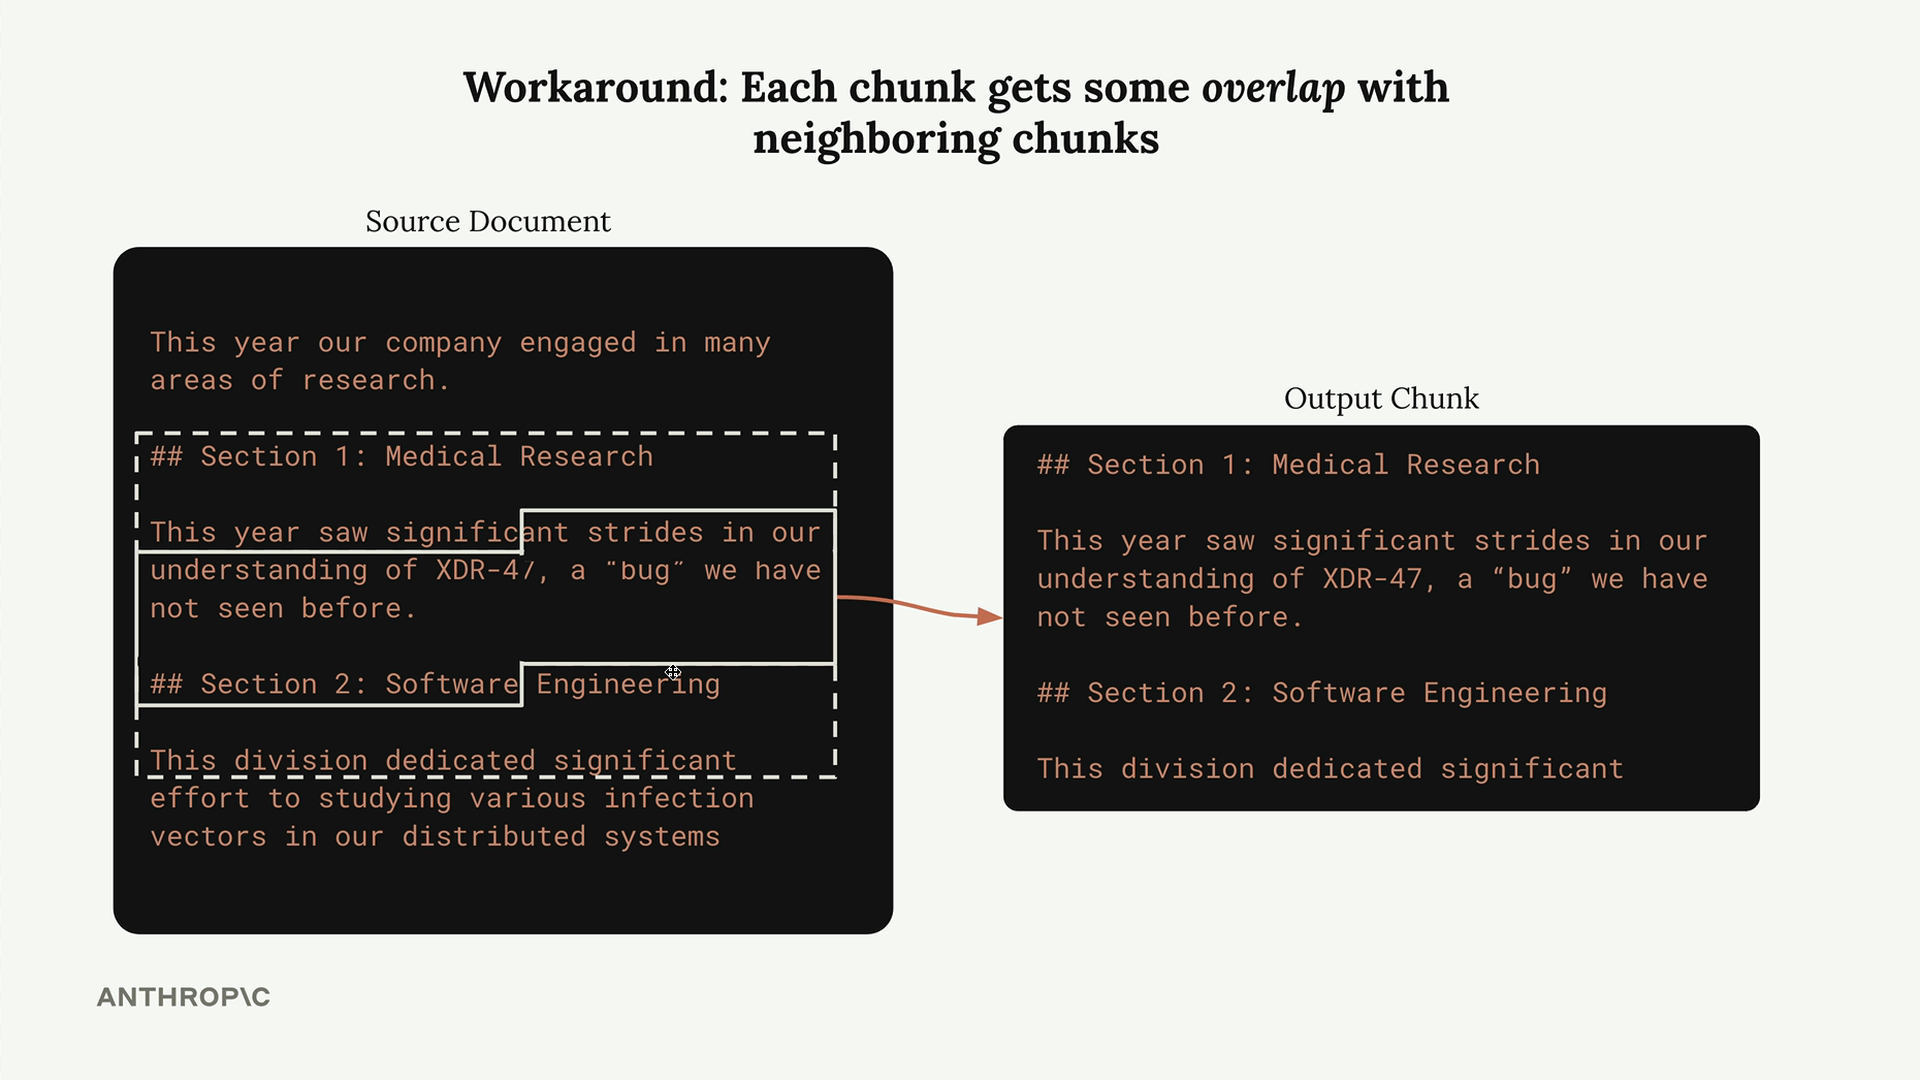
이는 약간의 중복을 만들어내지만, 각 청크가 얻는 향상된 컨텍스트를 고려하면 대체로 그만한 가치가 있는 트레이드오프입니다.
구조 기반 청킹
문서가 일관된 형식(명확한 헤더가 있는 마크다운 등)을 갖추고 있다면, 구조 기반 청킹은 훌륭한 결과를 낼 수 있습니다. 헤더와 같은 구조적 요소를 기준으로 분할하여 문서의 자연스러운 구성에 맞는 청크를 만듭니다.
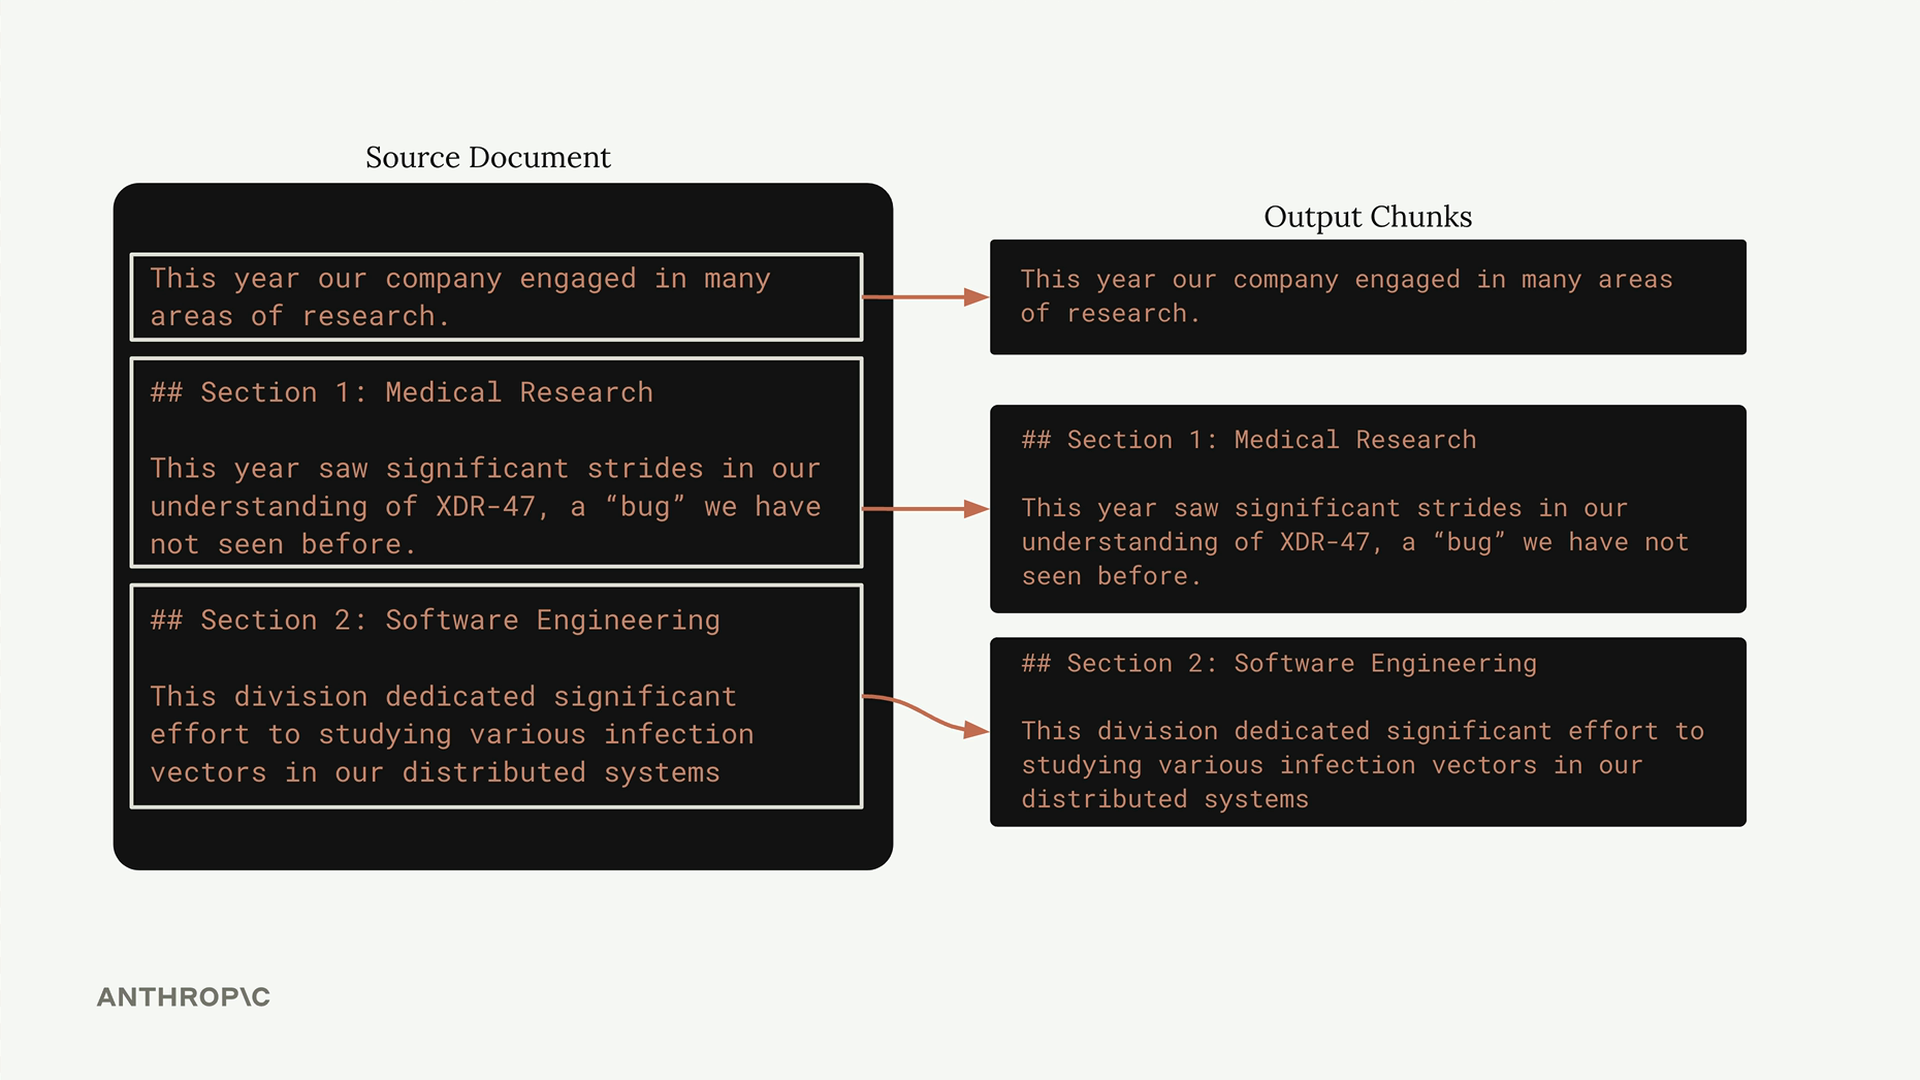
이는 잘 포맷된 문서에서는 훌륭하게 작동하지만 문서 구조에 대한 보장이 필요합니다. 일반 텍스트 파일이나 일관성 없이 포맷된 문서에서는 안정적으로 작동하지 않습니다.
구현 예시
다음은 구현할 수 있는 세 가지 실용적인 청킹 함수입니다:
문자 기반 청킹
문장 기반 청킹
섹션 기반 청킹
올바른 전략 선택하기
청킹 전략의 선택은 전적으로 특정 사용 사례에 따라 달라집니다:
- 문자 기반: 가장 신뢰할 수 있는 대안으로, 모든 문서 유형에서 작동합니다
- 문장 기반: 프로즈(prose)에 대해 컨텍스트와 의미의 균형이 좋습니다
- 섹션 기반: 구조화된 문서가 있을 때 훌륭한 결과를 제공합니다
포맷에 대한 보장이 없는 사용자 업로드 문서의 경우, 문자 기반 청킹이 가장 안전한 선택인 경우가 많습니다. 잘 구조화된 내부 문서의 경우, 섹션 기반 청킹이 더 우수한 결과를 제공할 수 있습니다. 문장 기반 청킹은 대부분의 프로즈에 잘 작동하지만 마침표를 예상치 못한 방식으로 사용하는 코드나 기술 문서에서는 어려움을 겪을 수 있습니다.
청킹은 종종 반복적인 과정이라는 점을 기억하세요. 간단한 접근 방식으로 시작하여 특정 문서와 사용 사례로 테스트한 다음, RAG 시스템에서 얻는 결과의 품질을 바탕으로 개선해 나가세요.