지금까지 구축한 하이브리드 검색 방식은 잘 작동하지만, 여전히 몇 가지 거친 부분이 남아 있습니다. 특정 용어로 검색하거나 약어를 사용할 때, 결과가 완벽하게 정렬되지 않을 수 있습니다. 예를 들어, "엔지니어링 팀이 INC-2023-Q4-011에 대해 무엇을 했나요?"라고 질문하면, 해당 특정 질문에 소프트웨어 엔지니어링 섹션이 더 관련성이 높음에도 불구하고 사이버보안 섹션이 먼저 반환될 수 있습니다.
LLM 기반 재순위화
재순위화는 벡터 인덱스와 BM25 인덱스의 결과를 병합한 후 추가적인 후처리 단계를 더합니다. 개념은 간단합니다: 검색 결과를 가져와서 Claude에게 사용자의 질문과의 관련성에 따라 재정렬하도록 요청하는 것입니다.
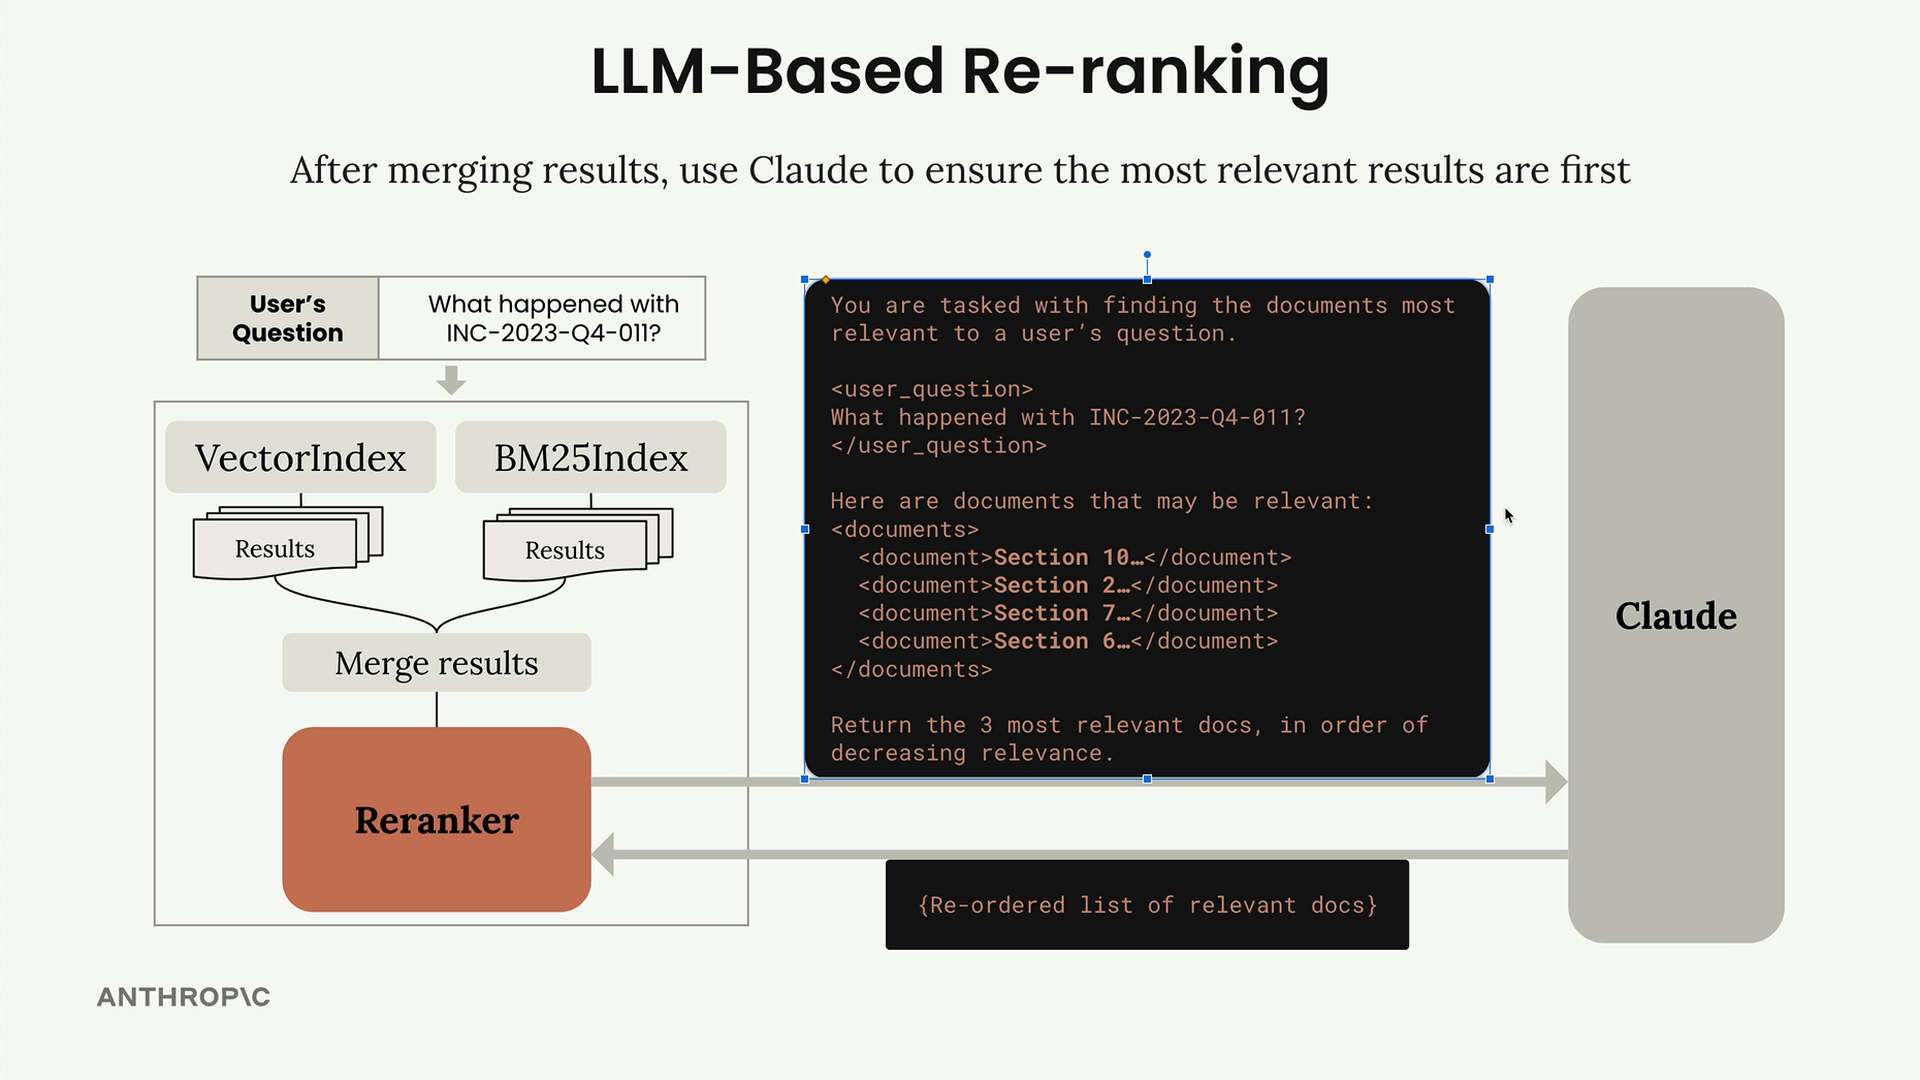
프로세스는 다음과 같이 작동합니다:
- 평소처럼 하이브리드 검색(벡터 + BM25)을 실행합니다
- 이전과 같이 결과를 병합합니다
- 병합된 결과를 재순위화 함수에 전달합니다
- 재순위화 함수는 특정 프롬프트와 함께 모든 것을 Claude에게 전송합니다
- Claude는 가장 관련성 높은 문서의 재정렬된 목록을 반환합니다
시스템 프롬프트
재순위화 프롬프트는 명확하고 구체적으로 설계되었습니다. 사용자의 질문과 관련성이 있어 보이는 모든 문서를 Claude에게 제공한 다음, 간단한 작업을 요청합니다: 관련성이 감소하는 순서로 가장 관련성 높은 문서를 반환하는 것입니다.
일반적인 프롬프트 구조는 다음과 같습니다:
You are tasked with finding the documents most relevant to a user's question.

<user_question>
What happened with INC-2023-Q4-011?
</user_question>

Here are documents that may be relevant:
<documents>
<document>Section 10...</document>
<document>Section 2...</document>
<document>Section 7...</document>
<document>Section 6...</document>
</documents>

Return the 3 most relevant docs, in order of decreasing relevance.효율성 고려사항
Claude에게 전체 텍스트 청크를 반환하도록 요청하는 것은 비효율적입니다 - Claude가 대량의 텍스트를 복사하는 것을 기다려야 하기 때문입니다. 대신, 각 텍스트 청크에 미리 고유한 ID를 할당하세요. 그런 다음 Claude에게 올바른 순서로 해당 ID만 반환하도록 요청하세요.
이 접근 방식은 Claude가 전체 문서 섹션을 복사하는 대신 ["1p5g", "51n3", "ab83"]와 같은 간단한 목록만 반환하면 되기 때문에 훨씬 빠릅니다.
구현
재순위화 함수는 초기 하이브리드 검색 이후 리트리버에 의해 자동으로 호출됩니다. 기본 구조는 다음과 같습니다:
결과
"엔지니어링 팀이 INC-2023-Q4-011에 대해 무엇을 했나요?"와 같은 질문으로 재순위화 함수를 테스트하면, 상단에 더 관련성 높은 결과가 표시되어야 합니다. Claude는 맥락을 이해하고, 엔지니어링 팀에 관한 질문이 해당 사건을 단순히 언급하는 다른 섹션보다 소프트웨어 엔지니어링 섹션을 우선시해야 한다는 것을 식별할 수 있습니다.
트레이드오프는 명확합니다: 재순위화는 Claude의 응답을 기다려야 하기 때문에 지연 시간을 증가시키지만, Claude의 맥락 및 관련성 이해를 활용하여 검색 정확도를 크게 향상시킵니다.